MÓDULO 1 · COMPREENDER
Inteligência Artificial generativa, LLM e funcionamento
Compreender o que acontece entre uma instrução e uma resposta.
OBJETIVOS
No final deste módulo deverá ser capaz de:
- Distinguir IA analítica de IA generativa.
- Explicar, de forma simples, o que é um LLM.
- Compreender como um modelo constrói uma resposta.
- Distinguir empresa, modelo e aplicação.
- Reconhecer limitações e situações de pesquisa e geração.
O que é a Inteligência Artificial?
A Inteligência Artificial corresponde a um conjunto de métodos computacionais que permite analisar dados, reconhecer padrões e produzir um resultado útil para uma tarefa. O sistema não recebe necessariamente uma regra para cada caso: em muitos sistemas atuais, aprende relações estatísticas a partir de exemplos.
O que significa isto no trabalho?
Quando um sistema separa mensagens por assunto, deteta uma operação fora do padrão, prevê a procura de um produto ou propõe uma resposta a um cliente, está a transformar dados de entrada num resultado. Esse resultado pode ser uma classificação, uma previsão, uma recomendação ou um conteúdo gerado.
Um sistema pode produzir uma resposta clara e convincente sem ter intenção, experiência pessoal, bom senso ou compreensão humana. Também não conhece automaticamente o contexto interno da organização.
IA analítica e IA generativa
As duas abordagens reconhecem padrões, mas respondem a necessidades diferentes. A escolha começa pela pergunta: queremos interpretar dados existentes ou produzir um novo conteúdo?
IA analítica
Trabalha sobre informação existente para classificar, detetar, prever e recomendar.
- Classificar: encaminhar pedidos por tema.
- Detetar: assinalar operações anómalas.
- Prever: estimar procura ou atrasos.
- Recomendar: ordenar opções por relevância.
Resultado típico: uma categoria, pontuação, alerta ou previsão.
IA generativa
Produz um conteúdo novo a partir das instruções, dos padrões aprendidos e do contexto recebido.
- Redigir: criar uma primeira versão de uma mensagem.
- Transformar: resumir ou simplificar um documento.
- Estruturar: organizar notas num relatório.
- Criar: gerar texto, imagem, áudio, vídeo ou código.
Resultado típico: um conteúdo que precisa de revisão antes da utilização.
Um sistema pode analisar reclamações para identificar temas recorrentes e, depois, gerar uma síntese. A primeira etapa é analítica; a segunda é generativa.
Da lógica à IA generativa: breve evolução
A Inteligência Artificial atual resulta de várias décadas de investigação. Cada período introduziu uma forma diferente de construir sistemas capazes de executar tarefas complexas.
As primeiras perguntas sobre máquinas inteligentes
Os primeiros trabalhos procuravam perceber se uma máquina poderia reproduzir comportamentos associados à inteligência humana. Em 1950, Alan Turing propôs um teste baseado na capacidade de uma máquina manter uma conversa sem ser facilmente distinguida de uma pessoa. Em 1956, a conferência de Dartmouth ajudou a consolidar a Inteligência Artificial como área de investigação.
Exemplo: programas que resolviam problemas de lógica ou demonstravam teoremas matemáticos seguindo regras previamente definidas.
Contributo: estabeleceu a ideia de que algumas formas de raciocínio poderiam ser representadas e executadas por computadores.
Sistemas especializados e conhecimento baseado em regras
Desenvolveram-se sistemas especializados, também conhecidos como sistemas periciais. O conhecimento de profissionais experientes era convertido em regras do tipo «se acontecer A, verificar B e recomendar C». Funcionavam bem em problemas delimitados, mas tinham dificuldade perante situações não previstas.
Exemplo: sistemas de apoio ao diagnóstico médico e aplicações empresariais utilizadas para configurar equipamentos ou apoiar decisões técnicas.
Limitação: exigiam a introdução manual de muitas regras, eram caros de manter e não aprendiam autonomamente com novos casos.
Aprendizagem automática a partir de dados
Em vez de depender apenas de regras escritas por especialistas, os sistemas passaram a identificar padrões em conjuntos de dados. Esta abordagem permitiu melhorar previsões e classificações à medida que aumentavam os dados disponíveis e a capacidade dos computadores.
Exemplo: filtros de correio eletrónico indesejado, deteção de fraude, recomendação de produtos e o sistema que, em 1997, venceu o campeão mundial de xadrez Garry Kasparov.
Contributo: a máquina deixou de depender exclusivamente de instruções explícitas para cada situação e passou a aprender relações estatísticas a partir de exemplos.
Aprendizagem profunda e redes neuronais
O crescimento dos dados digitais, o aumento da capacidade de processamento e o desenvolvimento de redes neuronais com várias camadas impulsionaram a aprendizagem profunda. Os sistemas passaram a reconhecer padrões muito complexos em imagem, voz e linguagem.
Exemplo: reconhecimento de objetos em fotografias, transcrição de voz, tradução automática, assistentes de voz e sistemas avançados de recomendação.
Marco importante: em 2017 foi apresentada a arquitetura Transformer, que permite analisar relações entre diferentes partes de uma sequência e está na base de muitos modelos de linguagem atuais.
Modelos de grande dimensão e IA generativa
Os modelos passaram a ser treinados com volumes muito elevados de dados e a executar várias tarefas através de instruções em linguagem natural. Em vez de serem construídos apenas para uma função, conseguem redigir, resumir, explicar, traduzir, analisar e gerar diferentes tipos de conteúdo.
Exemplo: criação de textos, imagens, áudio, vídeo, código informático, apresentações e assistentes integrados em aplicações de trabalho.
Desafio atual: maior capacidade não significa ausência de erros. Estes sistemas podem gerar informação falsa, reproduzir enviesamentos ou utilizar inadequadamente dados introduzidos pelo utilizador. A validação e a supervisão humana continuam indispensáveis.
A evolução da IA não corresponde à criação de uma mente humana digital. Corresponde ao desenvolvimento de métodos cada vez mais eficazes para reconhecer padrões, aprender com dados e gerar resultados.
O que é um LLM?
LLM é a sigla de Large Language Model, ou modelo de linguagem de grande dimensão. «Linguagem» indica que trabalha com sequências como texto; «grande dimensão» refere-se à quantidade de dados de treino e de parâmetros usados para representar relações complexas.
O que aprende durante o treino?
O modelo analisa um enorme número de exemplos e ajusta valores internos para aprender relações estatísticas: que termos aparecem em conjunto, como se estrutura um relatório, como varia o tom e que sequência é plausível num determinado contexto. Não guarda todo o treino como uma biblioteca de respostas prontas.
Perante «A reunião foi adiada para…», palavras como «segunda-feira», «amanhã» ou uma data podem ser continuações plausíveis. A instrução e o restante contexto alteram a probabilidade de cada opção.
Modelo, aplicação e organização
O modelo é o motor linguístico. A aplicação é a interface que pode acrescentar pesquisa, ficheiros, permissões e regras. A organização decide quais os dados e utilizações autorizados. Por isso, duas aplicações baseadas num modelo semelhante podem ter funcionalidades e níveis de proteção diferentes.
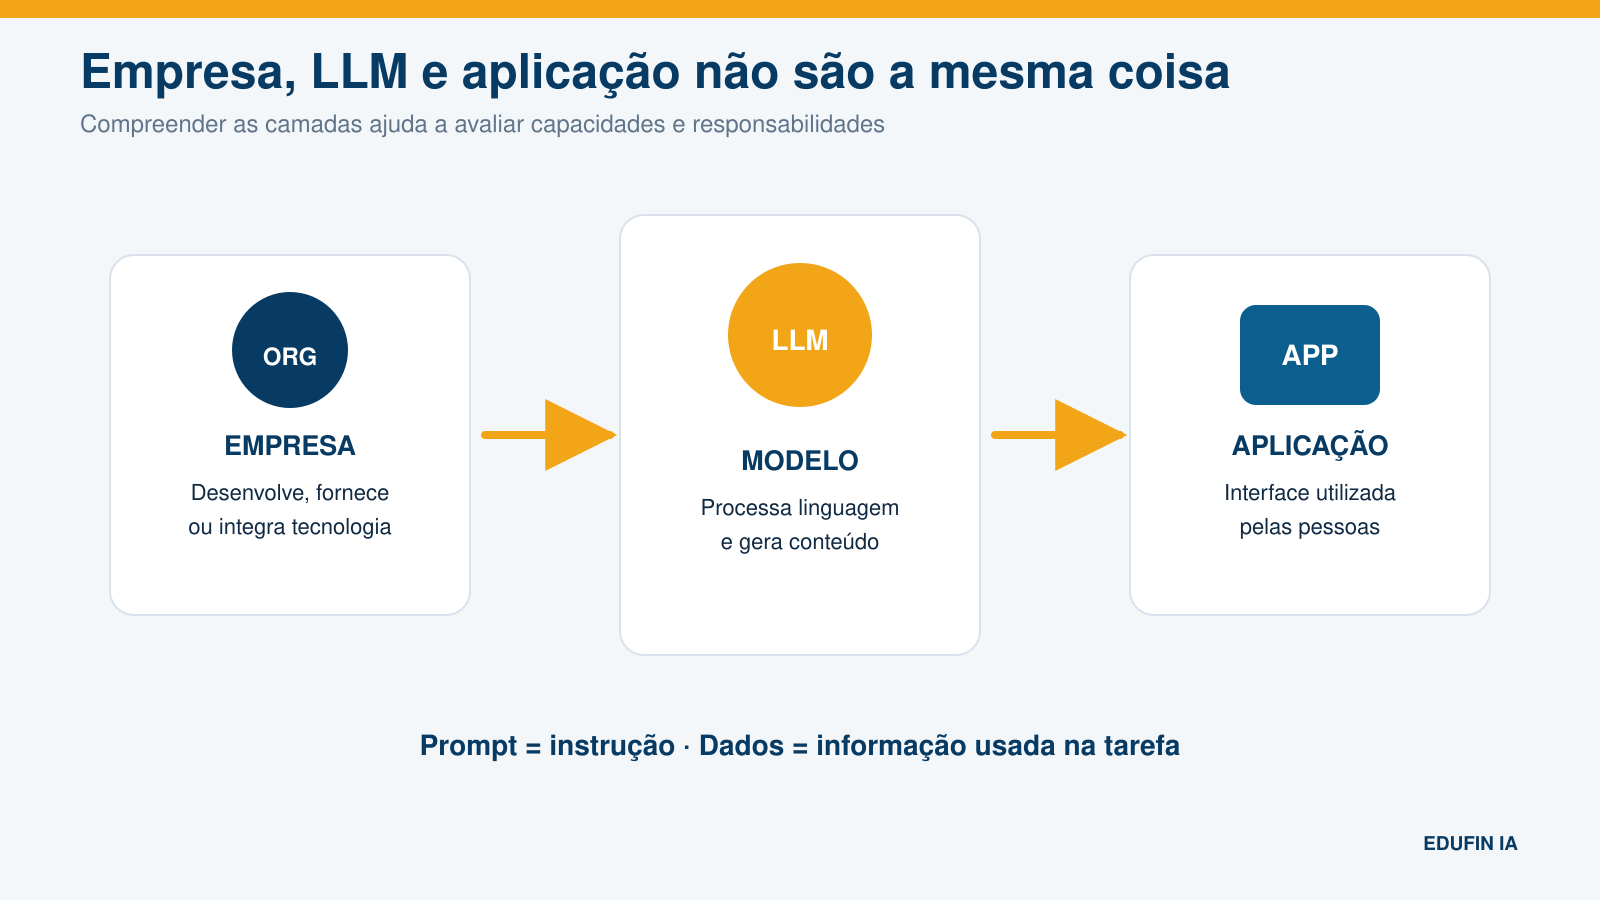
Não garante atualidade, exatidão, neutralidade nem adequação ao contexto profissional. Pode gerar uma afirmação plausível, mas falsa, fenómeno frequentemente designado por alucinação.
Como é construída uma resposta?
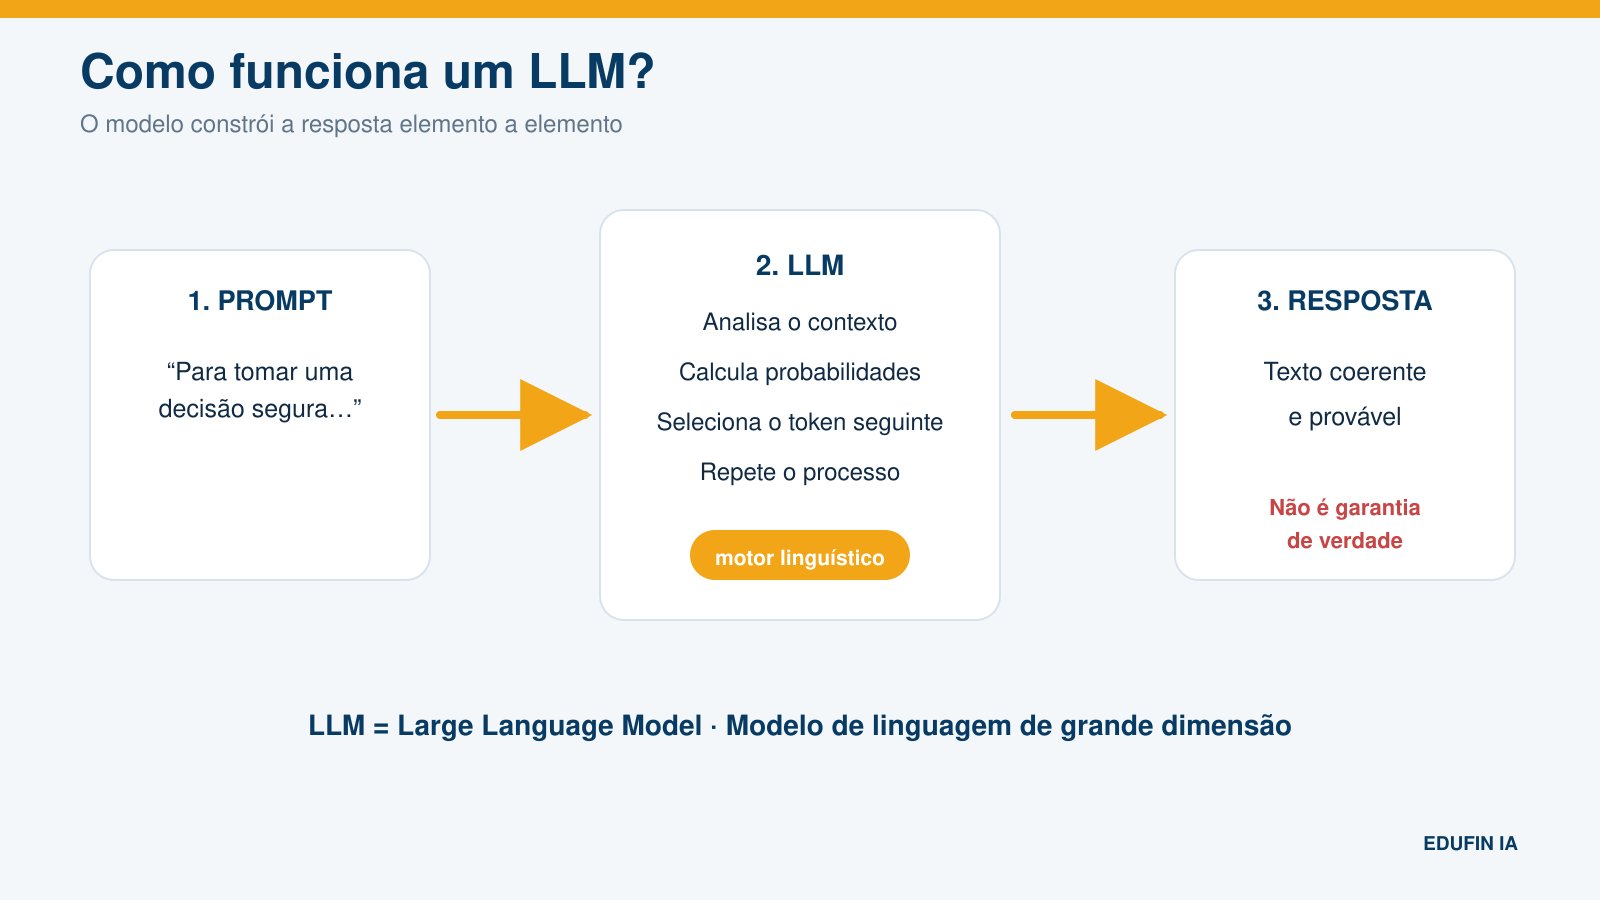
O sistema recebe a instrução, o histórico visível da conversa e, quando autorizado, documentos ou dados adicionais.
O conteúdo é dividido em unidades processáveis e convertido em representações numéricas.
O modelo relaciona as unidades e atribui maior relevância às partes úteis para interpretar o pedido.
Calcula várias continuações possíveis e seleciona uma de acordo com probabilidades e regras da aplicação.
Repete o cálculo token a token até concluir a resposta. Por isso, pequenas alterações no pedido podem originar resultados diferentes.
A resposta é construída no momento. A menos que a aplicação efetue pesquisa ou consulte fontes fornecidas, o modelo não está a confirmar cada frase numa base documental.
O que são tokens?
Antes de processar linguagem, o modelo converte o texto em pequenas unidades denominadas tokens. Um token pode corresponder a uma palavra curta, a parte de uma palavra, a um número ou a um sinal de pontuação. A divisão exata depende do modelo e da língua.
Porque é importante?
- Janela de contexto: cada modelo só consegue considerar uma quantidade limitada de tokens de cada vez.
- Perda de informação: numa conversa longa, partes antigas podem deixar de ser consideradas ou receber menos atenção.
- Custo e rapidez: em alguns serviços, a utilização é calculada pelos tokens enviados e gerados.
- Qualidade: incluir documentos excessivos e irrelevantes pode dificultar a identificação do contexto importante.
Em vez de anexar um arquivo inteiro, selecione os documentos pertinentes, indique o objetivo e peça que a resposta distinga claramente o que encontrou do que inferiu.
Como se desenvolve uma aplicação com um LLM?
Uma aplicação profissional não se resume a «ligar» um modelo. Deve ser desenhada como um processo controlado, com finalidade, dados, regras, testes e responsáveis definidos.
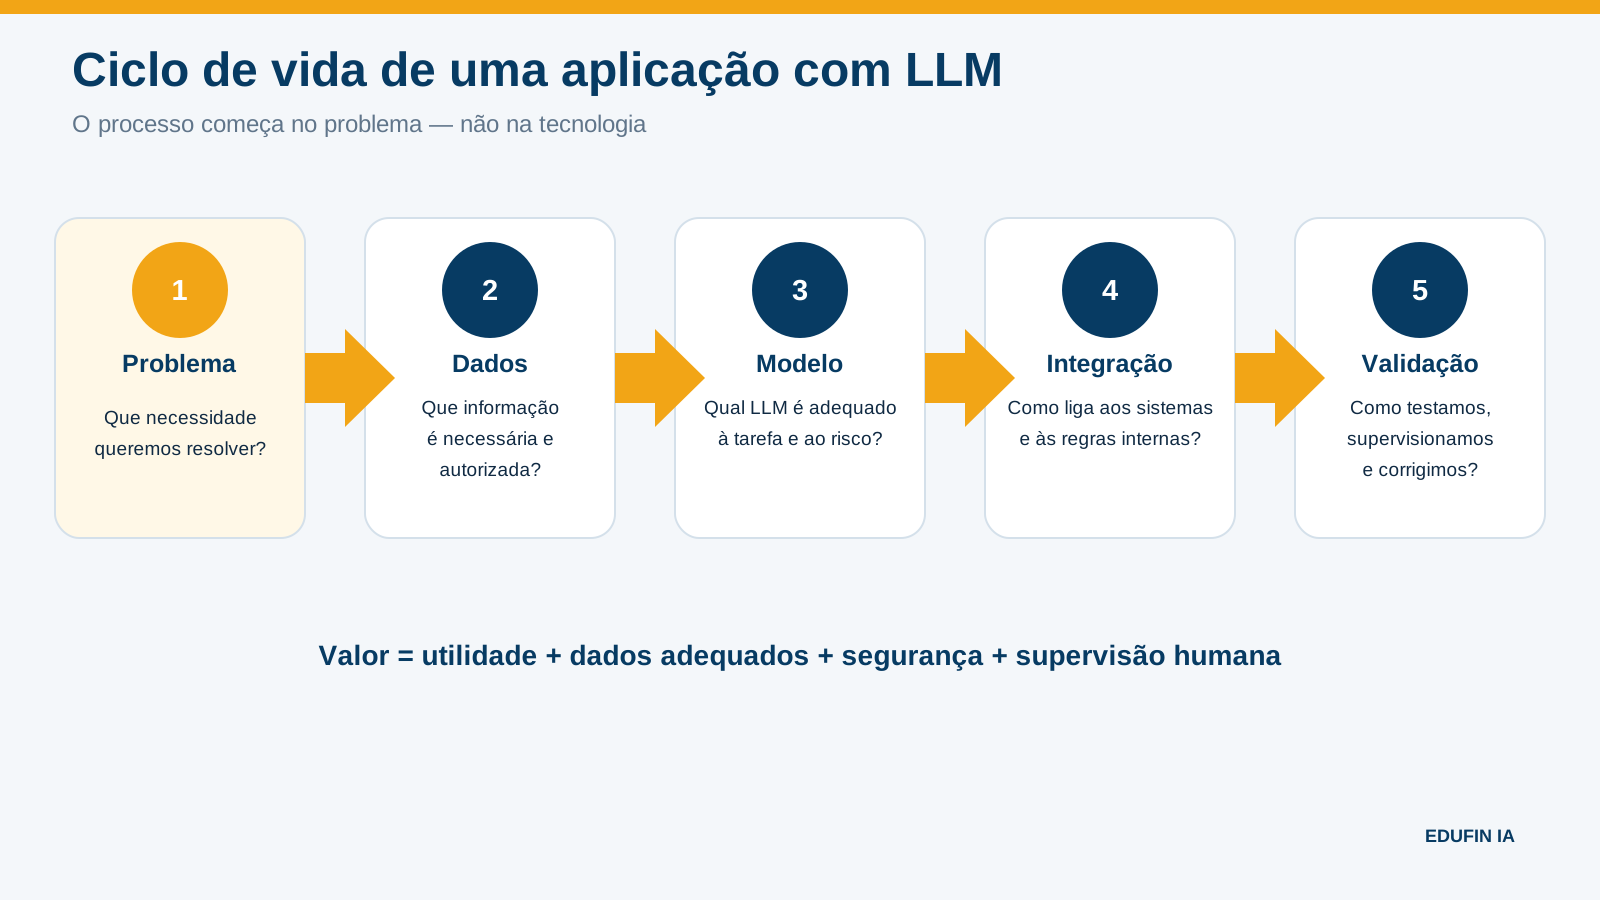
Definir a tarefa, os utilizadores, o benefício esperado e aquilo que a aplicação não deve fazer.
Identificar dados necessários, qualidade, base legal, confidencialidade, conservação e acessos.
Avaliar capacidade, língua, custo, segurança, contexto suportado e adequação ao risco.
Ligar documentos e sistemas, aplicar permissões, registar operações e criar salvaguardas.
Testar casos normais e casos-limite, medir erros, recolher feedback e definir supervisão humana.
O objetivo pode ser localizar instruções aprovadas. A aplicação recupera documentos internos autorizados, apresenta a resposta com a respetiva referência e encaminha dúvidas sensíveis para uma pessoa. Sem estes controlos, o modelo poderia responder com base em informação genérica.
Formas de adaptar um LLM
Adaptar não significa necessariamente voltar a treinar o modelo. Existem técnicas com objetivos, custos e graus de complexidade diferentes.
Engenharia de prompts
O que faz: melhora a instrução, o contexto, os critérios e o formato de saída.
Exemplo: pedir uma síntese em cinco pontos, destinada à direção, usando apenas o documento anexado.
Quando usar: tarefas pontuais e processos em que o utilizador controla a instrução.
Aprendizagem em contexto
O que faz: apresenta exemplos de entrada e resultado dentro da própria interação.
Exemplo: fornecer duas mensagens já classificadas para demonstrar as categorias pretendidas.
Limite: os exemplos ocupam contexto e não alteram permanentemente o modelo.
RAG — geração aumentada por recuperação
O que faz: pesquisa primeiro numa coleção documental autorizada e envia os excertos relevantes ao modelo.
Exemplo: responder sobre um procedimento interno com base na versão vigente e indicar a fonte.
Limite: uma recuperação deficiente ou documentos desatualizados produzem respostas deficientes.
Afinação do modelo
O que faz: ajusta o comportamento através de muitos exemplos selecionados.
Exemplo: aplicar de forma consistente uma classificação muito específica da organização.
Limite: exige dados de qualidade, testes, manutenção e maior investimento.
Mesmo quando utiliza documentos internos ou exemplos aprovados, a aplicação pode interpretar mal o pedido, recuperar o excerto errado ou gerar uma conclusão excessiva.
Pesquisa e geração não são a mesma coisa
Uma ferramenta de pesquisa localiza informação já publicada. Um modelo de geração constrói um conteúdo novo. Algumas aplicações combinam as duas, mas o utilizador deve perceber em que fontes a resposta se apoia.
Use pesquisa quando…
- precisa de legislação, preços ou dados atuais;
- tem de identificar a fonte original;
- a informação terá impacto financeiro, jurídico ou operacional;
- é necessário confirmar uma afirmação.
Use geração quando…
- pretende reformular um texto fornecido;
- quer estruturar ideias ou criar um rascunho;
- precisa de resumir ou comparar conteúdo disponível;
- o resultado será revisto antes de ser usado.
Quando a aplicação combina as duas
Peça as fontes, abra-as e confirme se sustentam realmente a afirmação. Uma ligação existente não prova que o conteúdo foi interpretado corretamente; uma fonte secundária pode ainda reproduzir um erro da fonte anterior.
Um conteúdo gerado não deve ser confundido com informação confirmada. Fluência é uma característica da escrita, não uma garantia de verdade.
Exercício individual
Analise cada tarefa e só depois abra a correção.
Localizar a versão atual de um regulamentoVer correção
É necessário consultar uma fonte oficial e atualizada.
Resumir um procedimento fornecidoVer correção
O modelo produz uma nova versão do conteúdo recebido.
Consultar dados oficiais e elaborar uma sínteseVer correção
Primeiro confirmam-se os dados; depois gera-se a síntese.
Confirmar o valor atual de uma taxaVer correção
O valor deve ser verificado na fonte oficial.
Teste final do Módulo 1
Responda às dez perguntas. Depois de selecionar uma opção, verá imediatamente a correção e a explicação. O teste considera o módulo concluído com 70% ou mais.